Managed GPU hosting voor AI
Laat je applicatie documenten analyseren, gesprekken omzetten naar tekst of informatie terugvinden in een eigen kennisbank. Met eigen GPU-capaciteit draai je AI-modellen in Nederland, klaar voor dagelijks gebruik.
Jij ontwikkelt de toepassing en kiest het model. Wij beheren de infrastructuur, softwarestack, beveiliging en monitoring. Zo voeg je AI toe aan je product, zonder zelf het beheer erbij te krijgen.
Eigen GPU-capaciteit voor jouw applicaties · Meerdere projecten met een eigen model · Verwerking in de Nederland
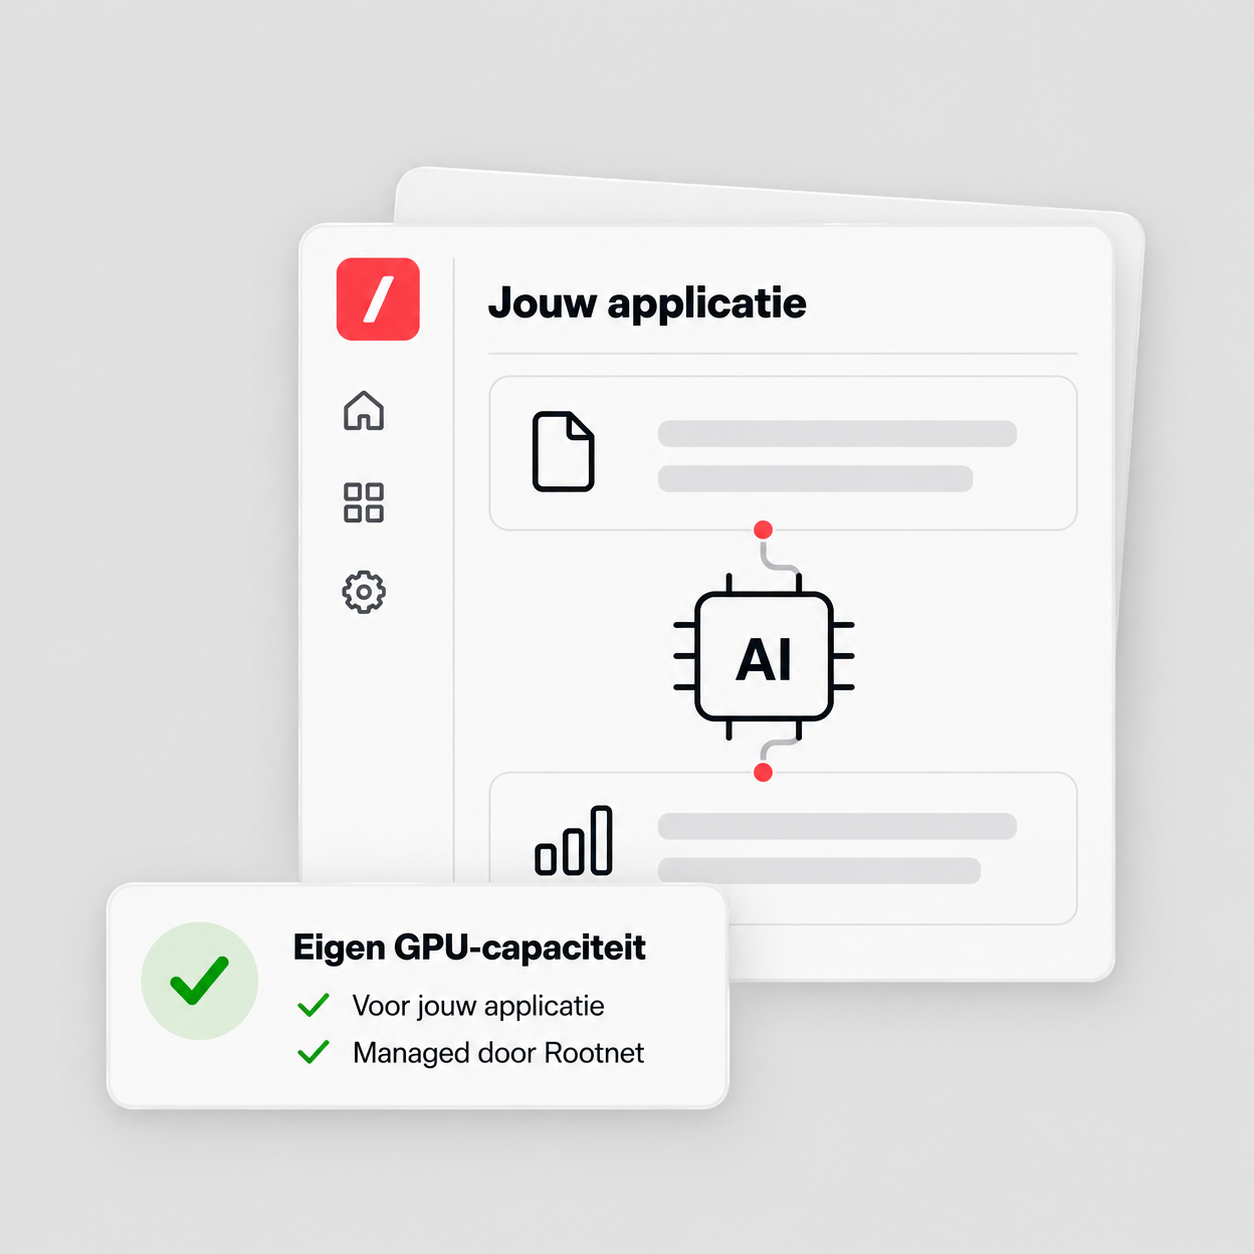
AI als vast onderdeel van je applicatie
Wanneer klanten op jouw AI-functionaliteit vertrouwen, wil je grip op de omgeving waarin deze draait. Op het model, de beschikbare capaciteit en de manier waarop gegevens worden verwerkt.
Met een eigen GPU-server draai je modellen zonder afhankelijk te zijn van de tokens van een externe AI-API. Je gebruikt de beschikbare capaciteit voor jouw applicaties en bepaalt zelf hoe je aanvragen en achtergrondtaken verdeelt.
Dat maakt eigen GPU-capaciteit interessant voor bijvoorbeeld SaaS-platformen die doorlopend documenten verwerken, analyses uitvoeren of AI-functionaliteit aan hun gebruikers aanbieden.
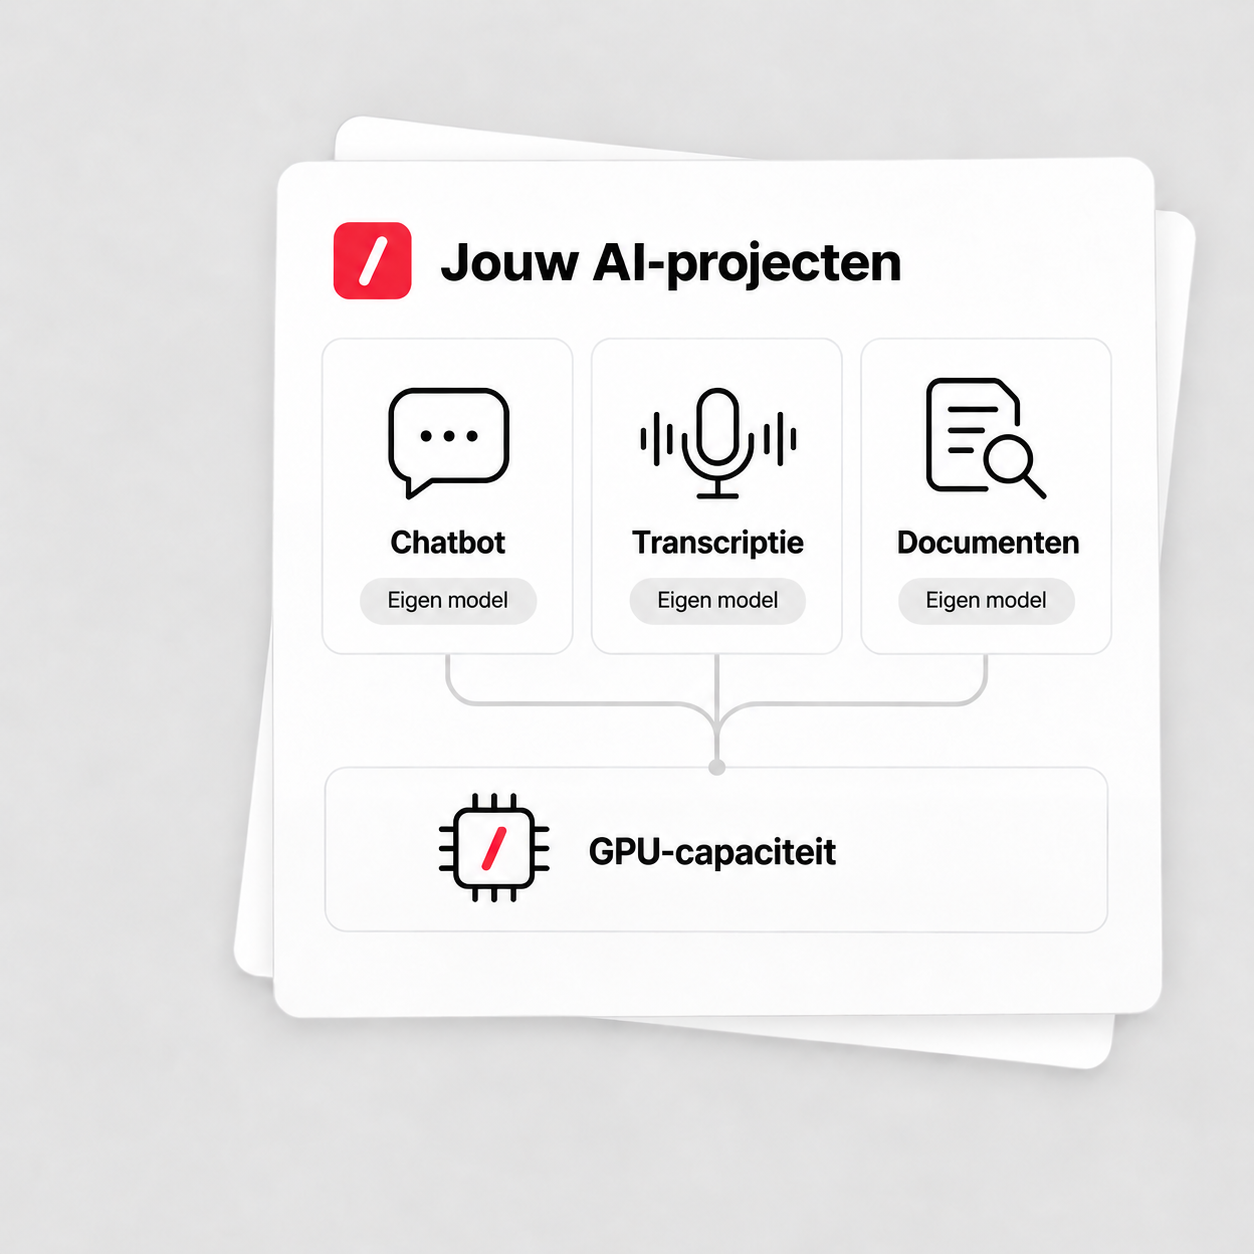
Meerdere modellen op één server
Een chatbot die klantvragen beantwoordt, vraagt om een ander AI-model dan een toepassing die gesprekken omzet naar tekst of informatie uit documenten opzoekt.
Op je GPU-server kun je meerdere projecten onderbrengen, elk met een eigen model en inrichting. Zo combineer je verschillende AI-functies binnen één hostingomgeving, zonder voor iedere toepassing een aparte server op te zetten.
De projecten delen de beschikbare GPU-capaciteit. Daarom stemmen we de inrichting af op het geheugengebruik, de verwachte belasting en welke modellen tegelijk actief moeten zijn.
Vanuit myRootnet houd je overzicht over je projecten en de hostingomgeving eronder.
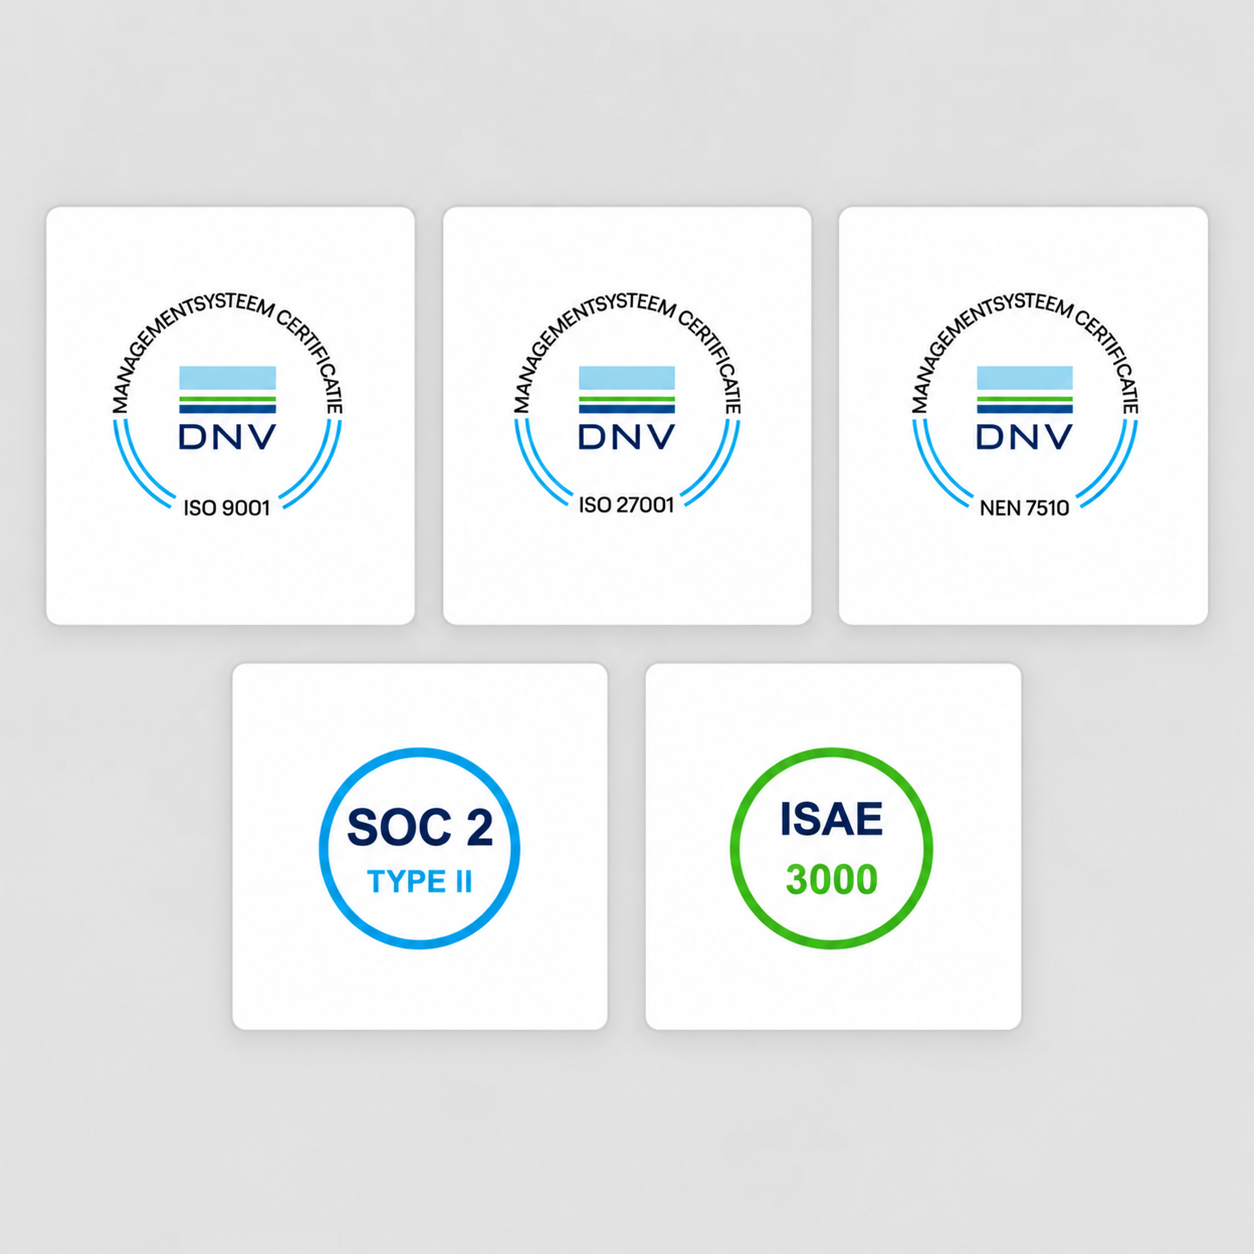
Vertrouwelijke gegevens verwerken in de Nederlandse cloud
Documenten, gesprekken en klantgegevens wil je niet zomaar naar een externe AI-dienst sturen. Door modellen binnen je eigen hostingomgeving te draaien, kun je deze gegevens verwerken zonder ze voor de modelaanvragen naar een externe AI-provider te verzenden.
Je omgeving draait op onze infrastructuur in Nederlandse datacenters. We richten de toegang tot de AI-service passend in, zodat alleen de bedoelde applicaties en gebruikers deze kunnen aanspreken.
Onze certificeringen voor informatiebeveiliging en zorginformatie, waaronder ISO 27001 en NEN 7510, ondersteunen die technische basis. Je team blijft verantwoordelijk voor het gebruik van persoonsgegevens, de inrichting van de applicatie en eventuele externe koppelingen.
Zo houd je niet alleen grip op het model, maar ook op de gegevens die je ermee verwerkt.
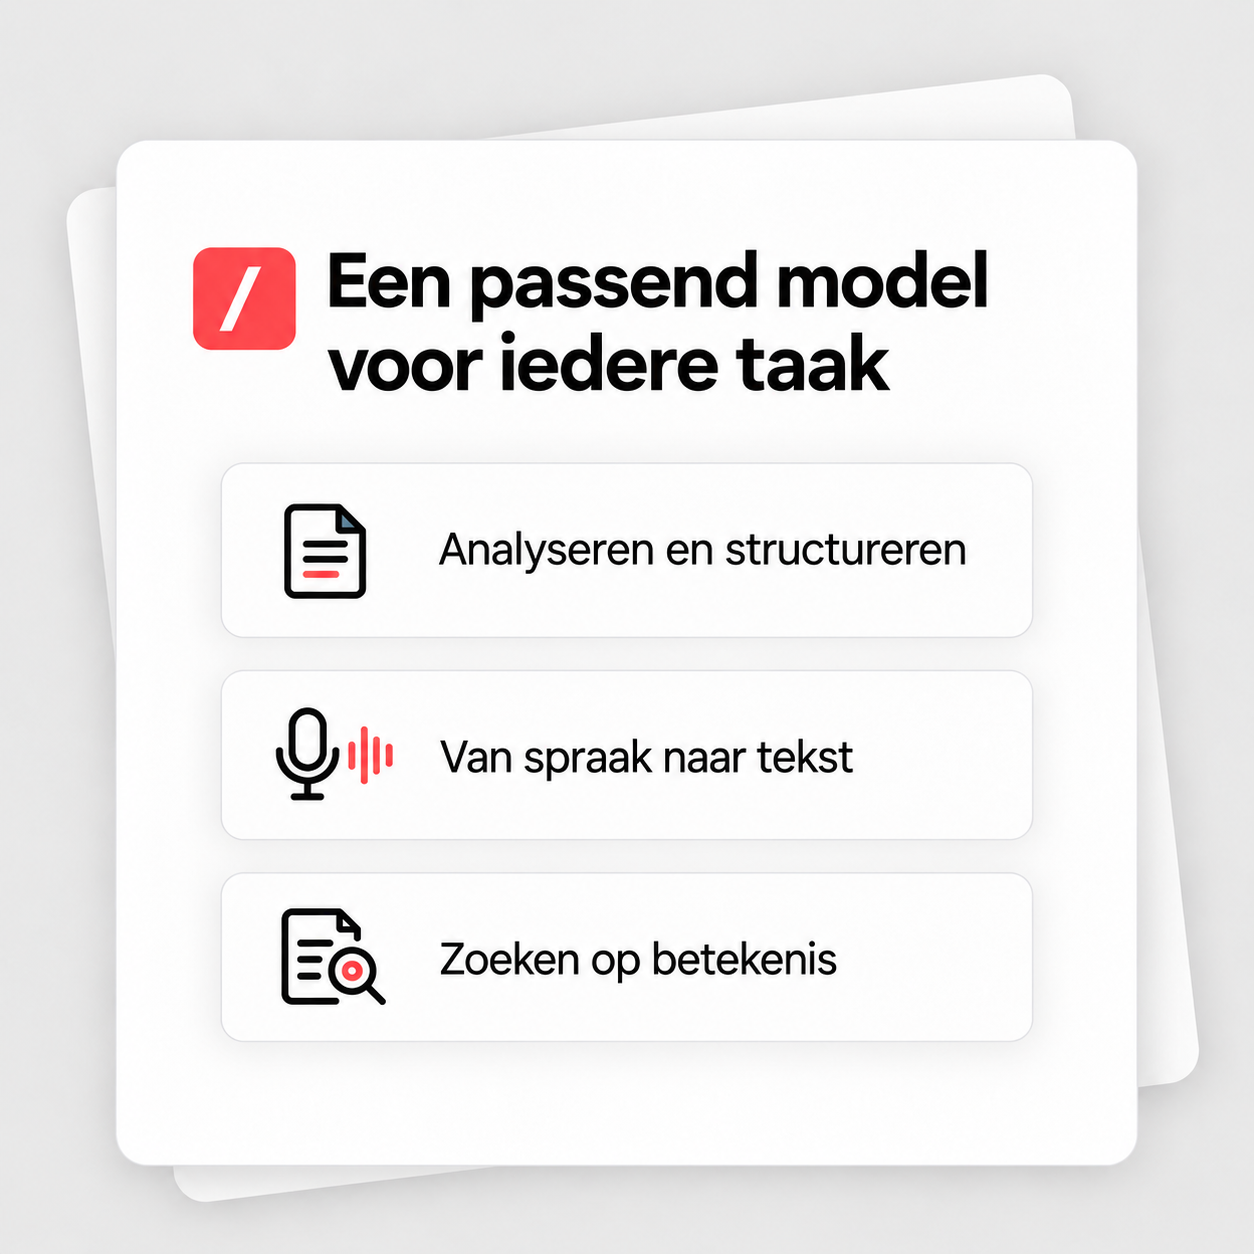
Een passend model voor iedere taak
Documenten analyseren en informatie structureren
Gebruik een taalmodel, bijvoorbeeld uit de Qwen-familie, om teksten samen te vatten, informatie uit documenten te halen of invoer te ordenen. Denk aan een applicatie die binnenkomende documenten omzet naar een voorstel dat een gebruiker controleert en verwerkt.
Gesprekken omzetten naar tekst
Met een spraakmodel zoals Whisper zet je audio om naar tekst binnen je eigen hostingomgeving. Bijvoorbeeld voor interviews, klantgesprekken of gesproken notities. Je applicatie kan het transcript vervolgens met een taalmodel laten samenvatten.
Informatie terugvinden in een eigen kennisbank
Een zoekmodel zoals BGE-M3 helpt relevante passages te vinden op basis van betekenis, niet alleen op exacte zoekwoorden. Combineer dit met een taalmodel om gebruikers antwoorden te laten vinden in hun eigen handleidingen, dossiers of documentatie.
Welk model past, hangt af van je gegevens, kwaliteitseisen en beschikbare capaciteit.
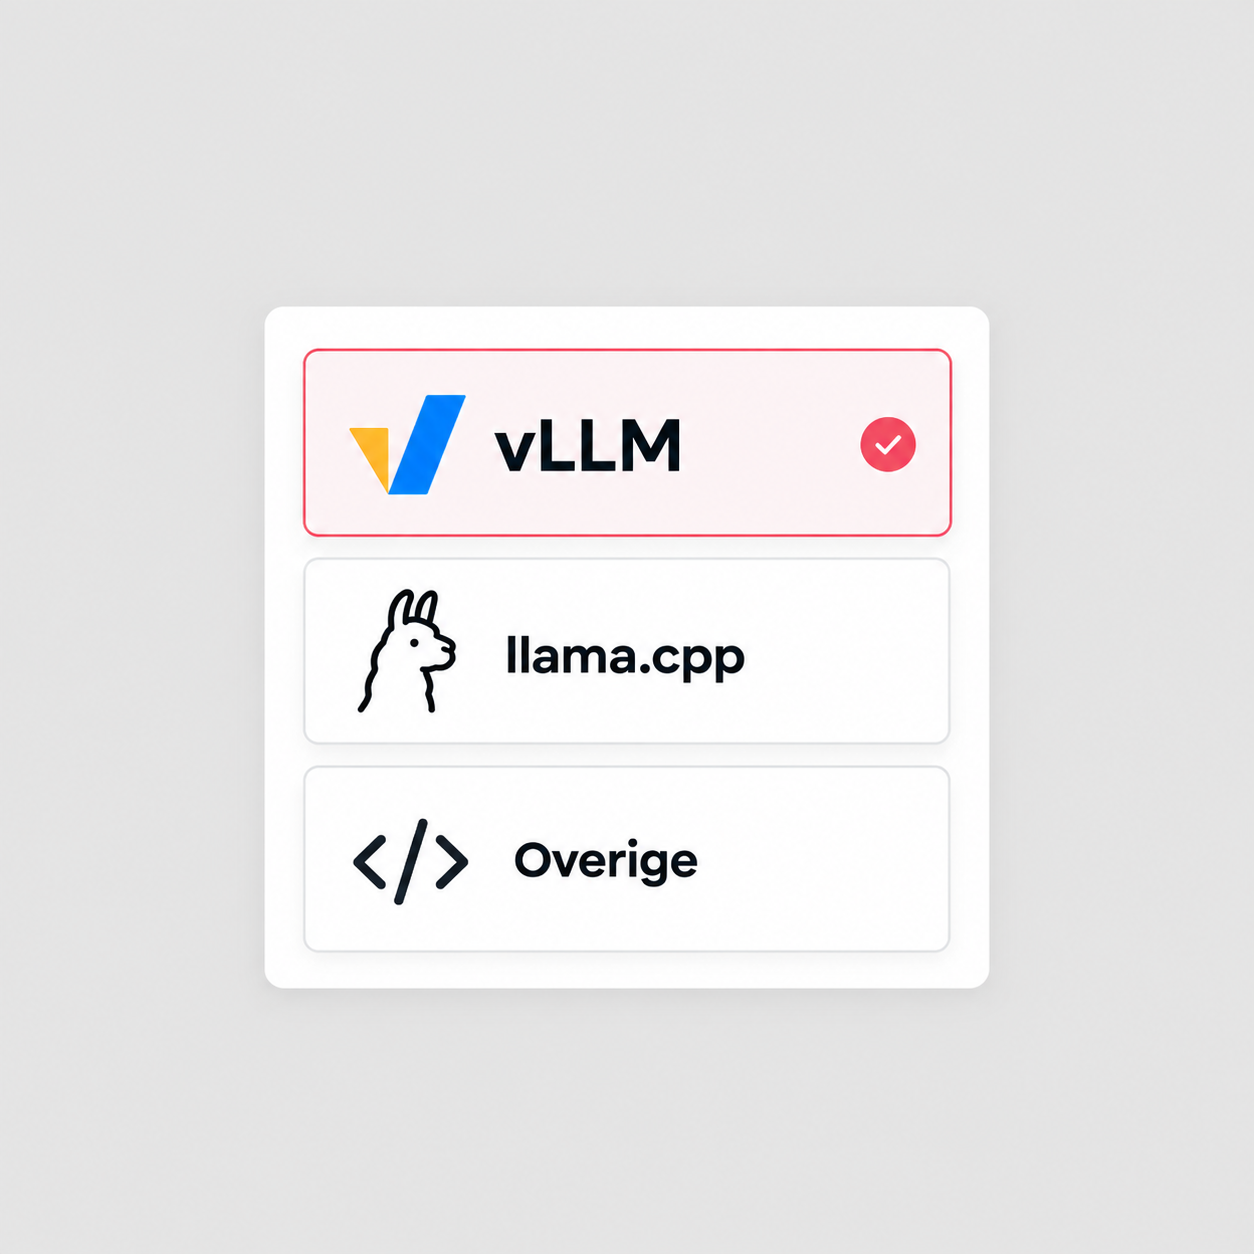
De juiste softwarestack achter jouw model
Jij kiest de toepassing. Wij zorgen voor een passende inrichting.
vLLM
Voor het beschikbaar maken van ondersteunde taalmodellen aan je applicatie, met aandacht voor gelijktijdige aanvragen en efficiënte verwerking. Via een OpenAI-compatible API kunnen veel bestaande integraties worden aangesloten.
llama.cpp
Voor het efficiënt draaien van ondersteunde taalmodellen, onder andere in compacte uitvoeringen die minder geheugen gebruiken. Geschikt voor gerichte AI-functies waarbij controle over de inrichting belangrijk is.
Andere modellen en toepassingen
Spraakherkenning, documentverwerking en zoekmodellen kunnen om andere software vragen. Daarom kijken we verder dan één framework en stemmen we de runtime, benodigde software en achtergrondprocessen af op jouw project.
NVIDIA Blackwell als technische basis
96 GB GPU-geheugen voor jouw AI-toepassingen.
Onze GPU-servers gebruiken de NVIDIA RTX PRO 6000 Blackwell Server Edition. Met 96 GB GDDR7-geheugen en Tensor Cores van de vijfde generatie biedt deze kaart ruimte en rekenkracht voor uiteenlopende AI-modellen.
Hoe je die capaciteit het beste benut, hangt af van je toepassing. Eén groter taalmodel, meerdere kleinere modellen of een combinatie van interactieve aanvragen en achtergrondverwerking: de inrichting volgt het gebruik.
We kijken daarom niet alleen naar de specificaties van de kaart, maar ook naar het model, het geheugengebruik en de gewenste responstijd.
Ervaar het zelf!
Geef jouw AI-toepassing een sterke basis met managed GPU-hosting in Nederland.
Wil je weten welke server bij jouw modellen en applicatie past? Neem contact op met Danny. Samen kijken we naar de benodigde capaciteit en een passende inrichting.