llama.cpp
Draai open AI-modellen efficiënt op infrastructuur die je zelf onder controle houdt.
Met llama.cpp zet je GGUF-modellen om in een lichte inference-service voor applicaties, agents en interne AI-toepassingen.
Wij beheren de infrastructuur en hostingomgeving eronder, zodat developers zich kunnen richten op het model en de applicatie.

Waarom llama.cpp hosting bij Rootnet?
Niet iedere AI-workload vraagt om een zware inference-stack.
Soms wil je vooral een compact model efficiënt draaien, inference op CPU gebruiken, een deel van het model naar een GPU offloaden of meerdere kleinere modellen flexibel beschikbaar maken.
Daar past llama.cpp goed bij.
Daarom combineren we de flexibiliteit van llama.cpp met een managed hostingomgeving.
Gebouwd voor efficiënte inference
llama.cpp is ontwikkeld om taalmodellen en andere generatieve AI-modellen efficiënt te draaien met zo min mogelijk overhead.
Het ondersteunt onder andere gequantiseerde modellen, CPU-inference, GPU-acceleratie en hybride CPU- en GPU-inference. Daardoor kan de omgeving worden afgestemd op het model en de beschikbare hardware.
GGUF als praktisch modelformaat
llama.cpp werkt met GGUF-modellen en kan compatibele modellen vanuit het Hugging Face-ecosysteem gebruiken.
Dat maakt het eenvoudig om verschillende open modellen te testen en een configuratie te kiezen die past bij geheugen, snelheid en gewenste modelkwaliteit.
Haal het maximale uit je llama.cpp hosting
Laat je website, webshop of applicatie sneller presteren met een hostingplatform dat is gebouwd voor snelheid, stabiliteit en groei.
- Met 24/7 monitoring en pro-actieve support bewaken wij de performance, bereikbaarheid en veiligheid van jouw projecten.
- Tijd is kostbaar en soms wil je gewoon direct geholpen worden. Wij zijn tijdens kantoortijden telefonisch bereikbaar voor al je vragen.
- Bij al onze servers is standaard een uitgebreide Service Level Agreement (SLA) inbegrepen.
Geschikt voor compacte AI-workloads
llama.cpp is vooral interessant wanneer flexibiliteit en efficiënt gebruik van hardware belangrijk zijn.
Denk bijvoorbeeld aan:
- interne AI-assistants;
- kleinere taalmodellen;
- documentclassificatie;
- samenvattingen;
- embeddings;
- reranking;
- RAG-toepassingen;
- agents;
- development- en testomgevingen;
- AI-functionaliteit binnen SaaS-applicaties.
Voor zeer hoge aantallen gelijktijdige inference-requests of grote GPU-clusters kan een gespecialiseerde serving-engine zoals vLLM een betere keuze zijn.
Je eigen AI-service op Nederlandse infrastructuur
Met llama.cpp kun je open modellen binnen je eigen hostingomgeving beschikbaar maken.
Dat kan interessant zijn voor organisaties die meer controle willen over:
- waar inference plaatsvindt;
- welke modellen worden gebruikt;
- toegang tot de modelservice;
- integratie met bestaande applicaties;
- voorspelbaarheid van de infrastructuur.
Applicaties communiceren met een interne of afgeschermde API terwijl het model op de eigen managed omgeving draait.
Dat betekent niet automatisch dat self-hosted inference voor iedere toepassing beter is dan een externe API.
Daarom kijken we samen naar gebruik, modelgrootte en performance-eisen voordat we bepalen welke architectuur passend is.
24/7 monitoring
Wanneer een model onderdeel wordt van een applicatie, wordt ook de beschikbaarheid van de inference-service belangrijk.
Daarom kunnen we de onderliggende serveromgeving en relevante processen 24/7 monitoren.
We houden onder andere zicht op serverbelasting, beschikbare opslag en processen die nodig zijn om de AI-service te laten draaien.
Detecteert onze monitoring een verstoring, dan krijgen onze engineers automatisch een melding en kunnen zij ingrijpen.
Zo wordt de inference-service onderdeel van dezelfde managed omgeving als de rest van je applicatie.
Alles beheren vanuit myRootnet
Managed hosting betekent niet dat je voor iedere wijziging bij ons moet aankloppen.
Vanuit myRootnet houd je controle over het dagelijkse beheer van de serveromgeving.
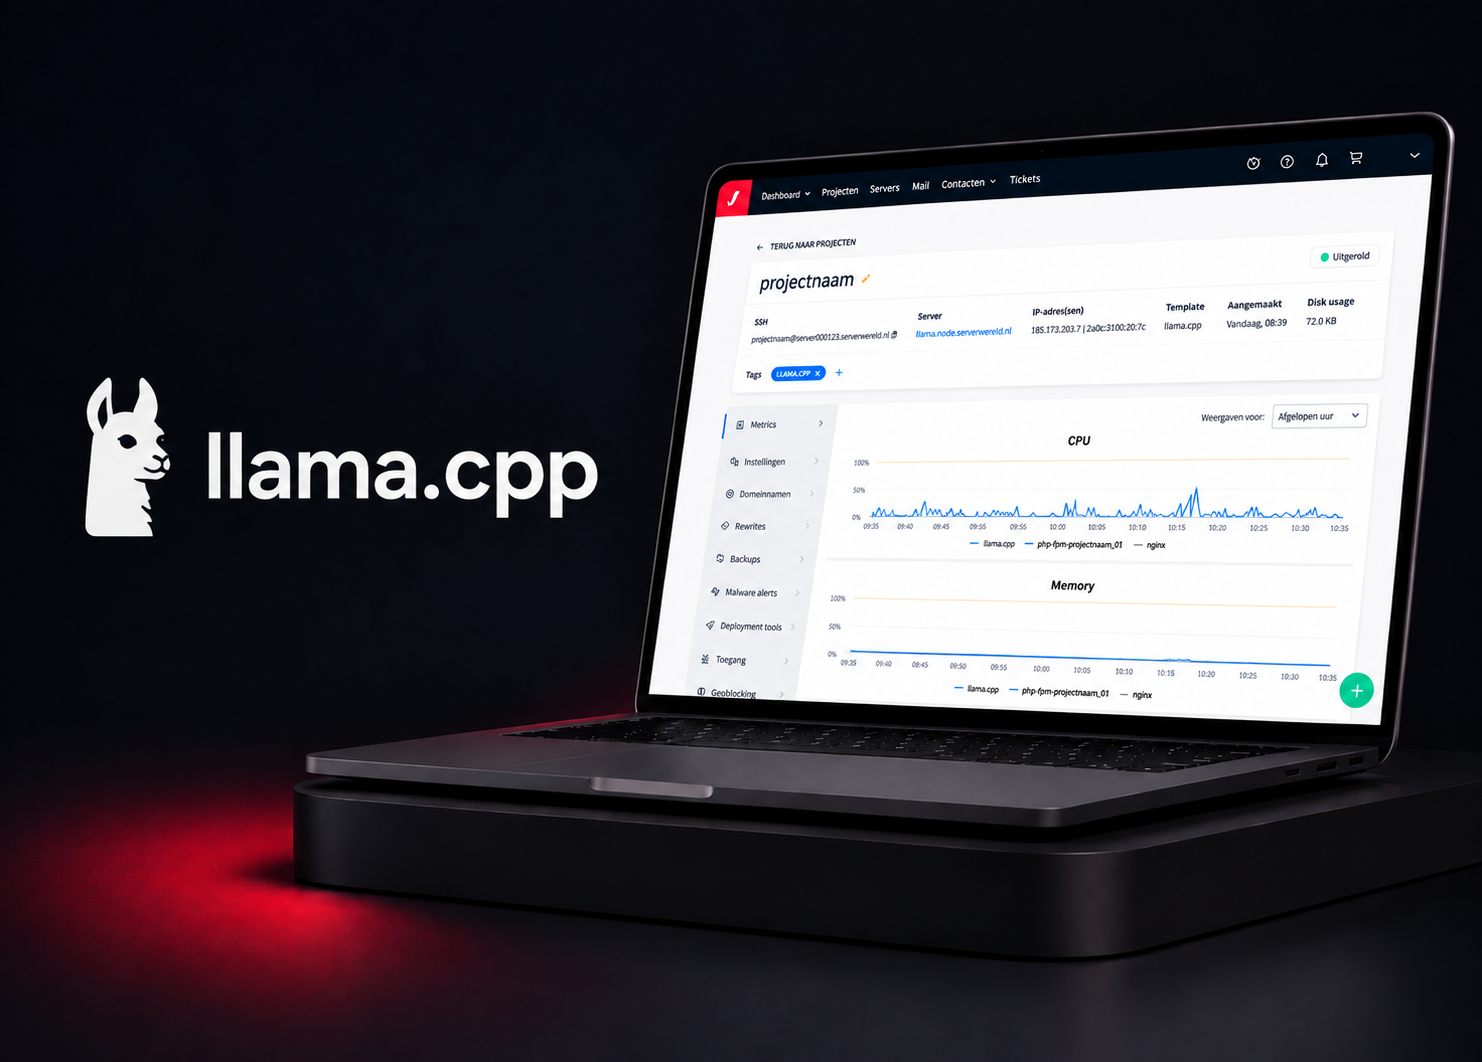
Bekijk realtime servermetrics, beheer projecten en domeinen, regel DNS en geef developers toegang via Role Based Access en persoonlijke SSH-keys.
Wij beheren de onderliggende infrastructuur en serverstack. Developers houden controle over llama.cpp, modellen en applicatieconfiguratie.
Ervaar het zelf!
Haal het beste uit jouw Concrete CMS websites dankzij de ideale managed hosting setup. Heb je vragen of wil je onze managed hosting 14 dagen vrijblijvend proberen? Neem gerust contact met Danny op!